AIにスライド作成を頼むと、見栄えのする資料は、すぐに出てくるようになりました。
では、「このまま経営会議に出せる」と言える資料は、どうすれば出てくるのでしょうか。
この疑問を確かめるため、まったく同じ一文を、3つのAIに投げてみました。テーマは「中小企業のAI活用動向」です。条件をそろえ、人の手直しを入れずに出てきた10枚同士を、全ページ並べて比べた結果を、本コラムでご報告します。
結論を先に書きます。差がついたのは、デザインの上手さではありませんでした。出典の確かさ、数字の検算、図表の作法、そして資料としての体裁の完成度でした。そして、その差を生んだのは、AIモデルそのものではなく、モデルに何を読ませ、どの工程で作らせるかという「スキル(指示と規約の一式)」の有無でした。
この記事でわかること
・同じプロンプトでも、AIによってスライドの「中身の確かさ」がどれだけ変わるか
・Claude版・ChatGPT版の、良い点と弱点(実物画像つき)
・数字の出典・検算・図表の作法で、差がつく具体的なポイント
・ON.のスライド作成スキルが、作成前に決めている規約と工程
・この検証の限界(1回限りの試行であることなど)
1. 検証の条件:プロンプトは、この一文だけ
検証に使ったプロンプトは、3つとも同一です。
「中小企業のAI活用動向をスライドに10枚でまとめて、PDFでください。」
条件は、次のとおりです。
・枚数は10枚、形式はPDF(16:9)で統一しました
・追加の指示、修正依頼、人の手直しは、3つとも入れていません(いわゆる「1発目」の比較です)
・Claude版とChatGPT版は、各サービスの通常の使い方で作成したものです
・ON.スキル版は、同じ一文を、ON.が業務で使っている「戦略コンサルタントスキル」と「スライド作成スキル」を読み込んだ状態のAIに渡したものです。プロンプト自体は変えていません。なお、スキルが定める工程(構成の確認、見本の確認、機械チェック、全ページの目視)は、スキルの一部として含みます。スライドそのものへの人の手直しはしていません
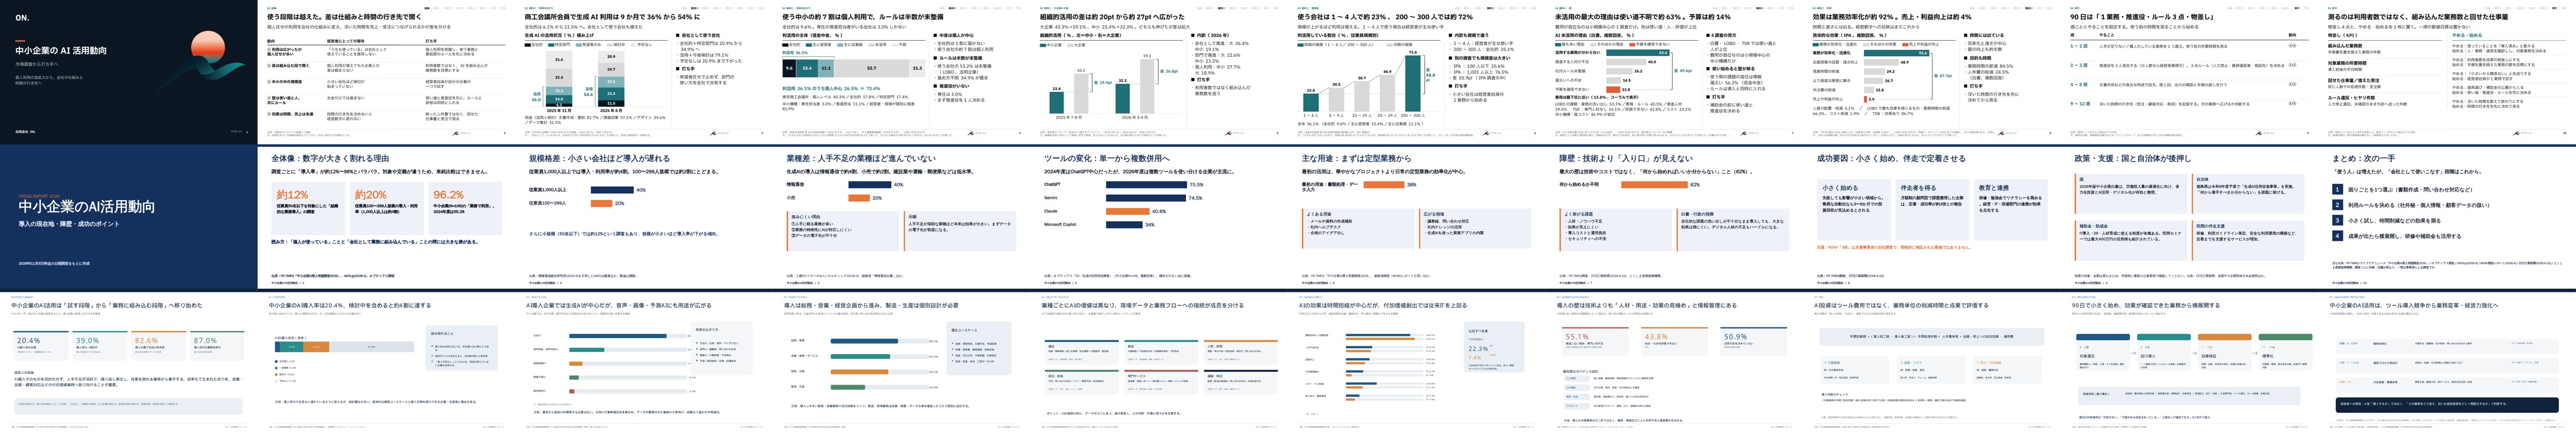
・比較は、全30ページを画像化して目視し、あわせて文字量、数値の出現回数などを機械的にも数えました
2. 結果の要約:70点満点で、65点/50点/36点
まず、採点結果からご覧ください。採点は、全ページを読み、7つの観点で10点ずつ、70点満点で付けたものです(採点の主体はON.編集側です。限界は第10節に明記します)。
| 観点 | ON.スキル版 | ChatGPT版 | Claude版 |
|---|---|---|---|
| ① 結論と構成 | 9 | 8 | 6 |
| ② 出典とデータの信頼性 | 10 | 7 | 4 |
| ③ 数字の整合と検算 | 10 | 7 | 5 |
| ④ 図表の設計 | 9 | 7 | 5 |
| ⑤ 可読性とビジュアル | 9 | 7 | 5 |
| ⑥ 打ち手の具体性 | 9 | 8 | 5 |
| ⑦ 資料としての体裁 | 9 | 6 | 6 |
| 合計 | 65 | 50 | 36 |
数字でも、差ははっきり出ています。
| 測ったもの | ON.スキル版 | ChatGPT版 | Claude版 |
|---|---|---|---|
| ページ数 | 10枚 | 10枚 | 10枚 |
| 資料の文字数(空白除く) | 約4,340字 | 約4,230字 | 約2,220字 |
| 数値(%・pt・サンプル数など)の出現回数 | 93回 | 50回 | 18回 |
| 主なデータページで、出典に調査名・時点・サンプル数がそろうか | 6ページすべてでそろう | おおむねそろう | サンプル数の明記は実質1ページのみ |
| 計算の過程を注記したページ | 6ページすべて | なし | なし |
読み解きはシンプルです。情報の量と確かさではON.スキル版が、内容の組み立てではChatGPT版も健闘し、Claude版は「概数で語る要約」に寄りました。一方でChatGPT版には表紙がなく、Claude版には余白の目立つページがあるなど、資料の体裁にも差が出ました。 次節から、実物で見ていきます。
3. まず実物を見る:表紙と結論ページ
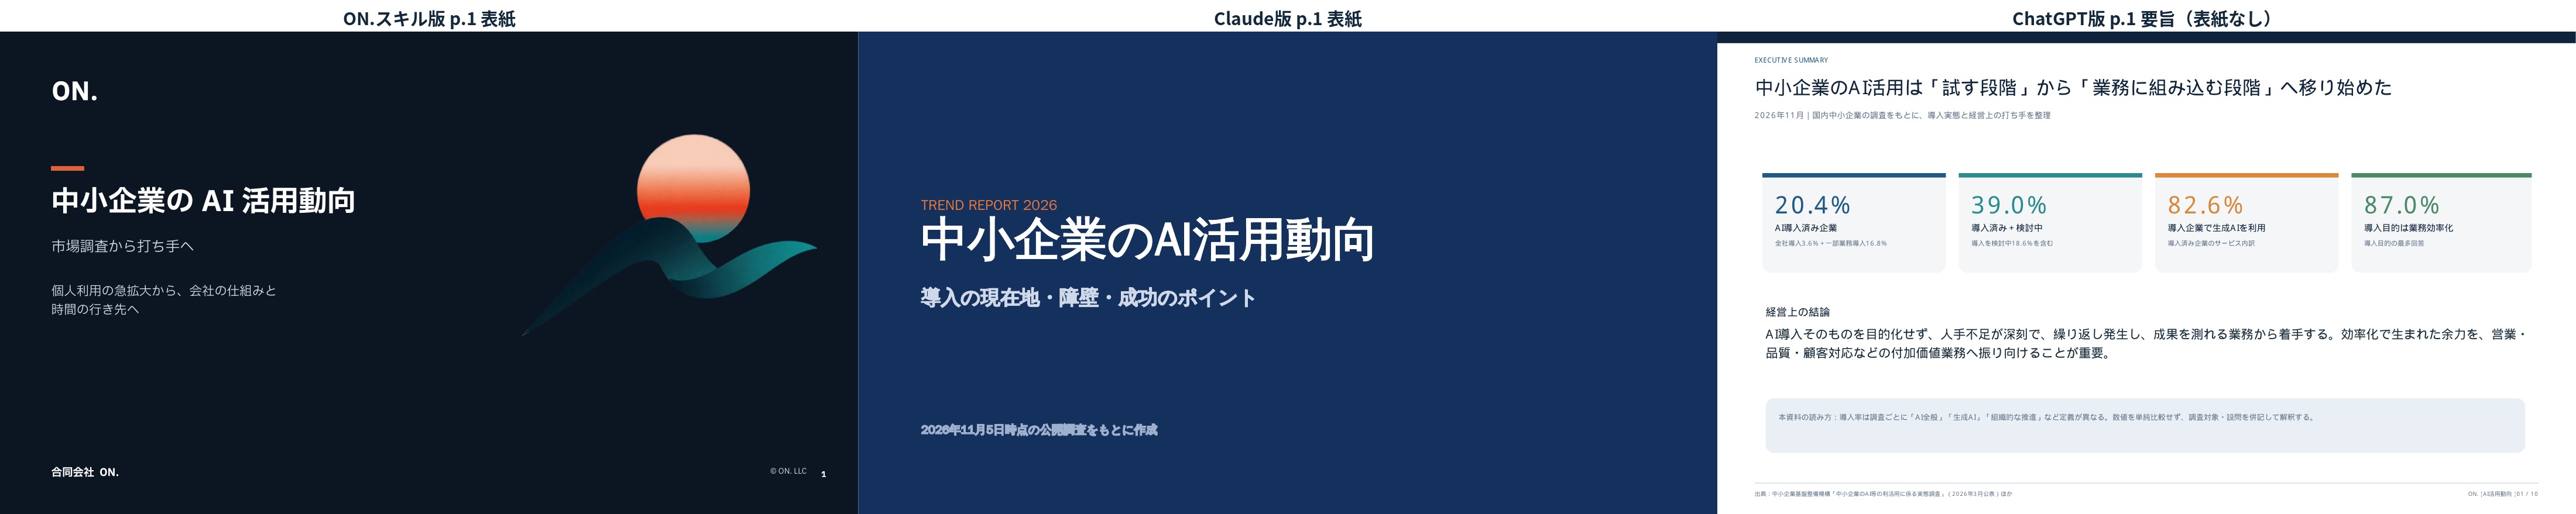
1枚目から、性格が出ます。
ON.スキル版は、表紙です。タイトル「中小企業のAI活用動向」に、副題「市場調査から打ち手へ」、そして本編の結論につながる一文「個人利用の急拡大から、会社の仕組みと時間の行き先へ」を置きました。誰の、どんな資料かが一目で分かります。
Claude版も表紙です。「TREND REPORT 2026」という見せ方は洗練されています。ただし、全体に余白が多く、ページによっては下半分がほぼ空白で、10枚の資料としての情報の置き方には物足りなさが残ります(第6節)。
ChatGPT版には、表紙がありません。1枚目から要旨(エグゼクティブサマリー)で、数字のカード4枚と「経営上の結論」が置かれています(図1右)。いきなり本論から入る構成で、タイトルと発行元を示す導入のページは省略されています。
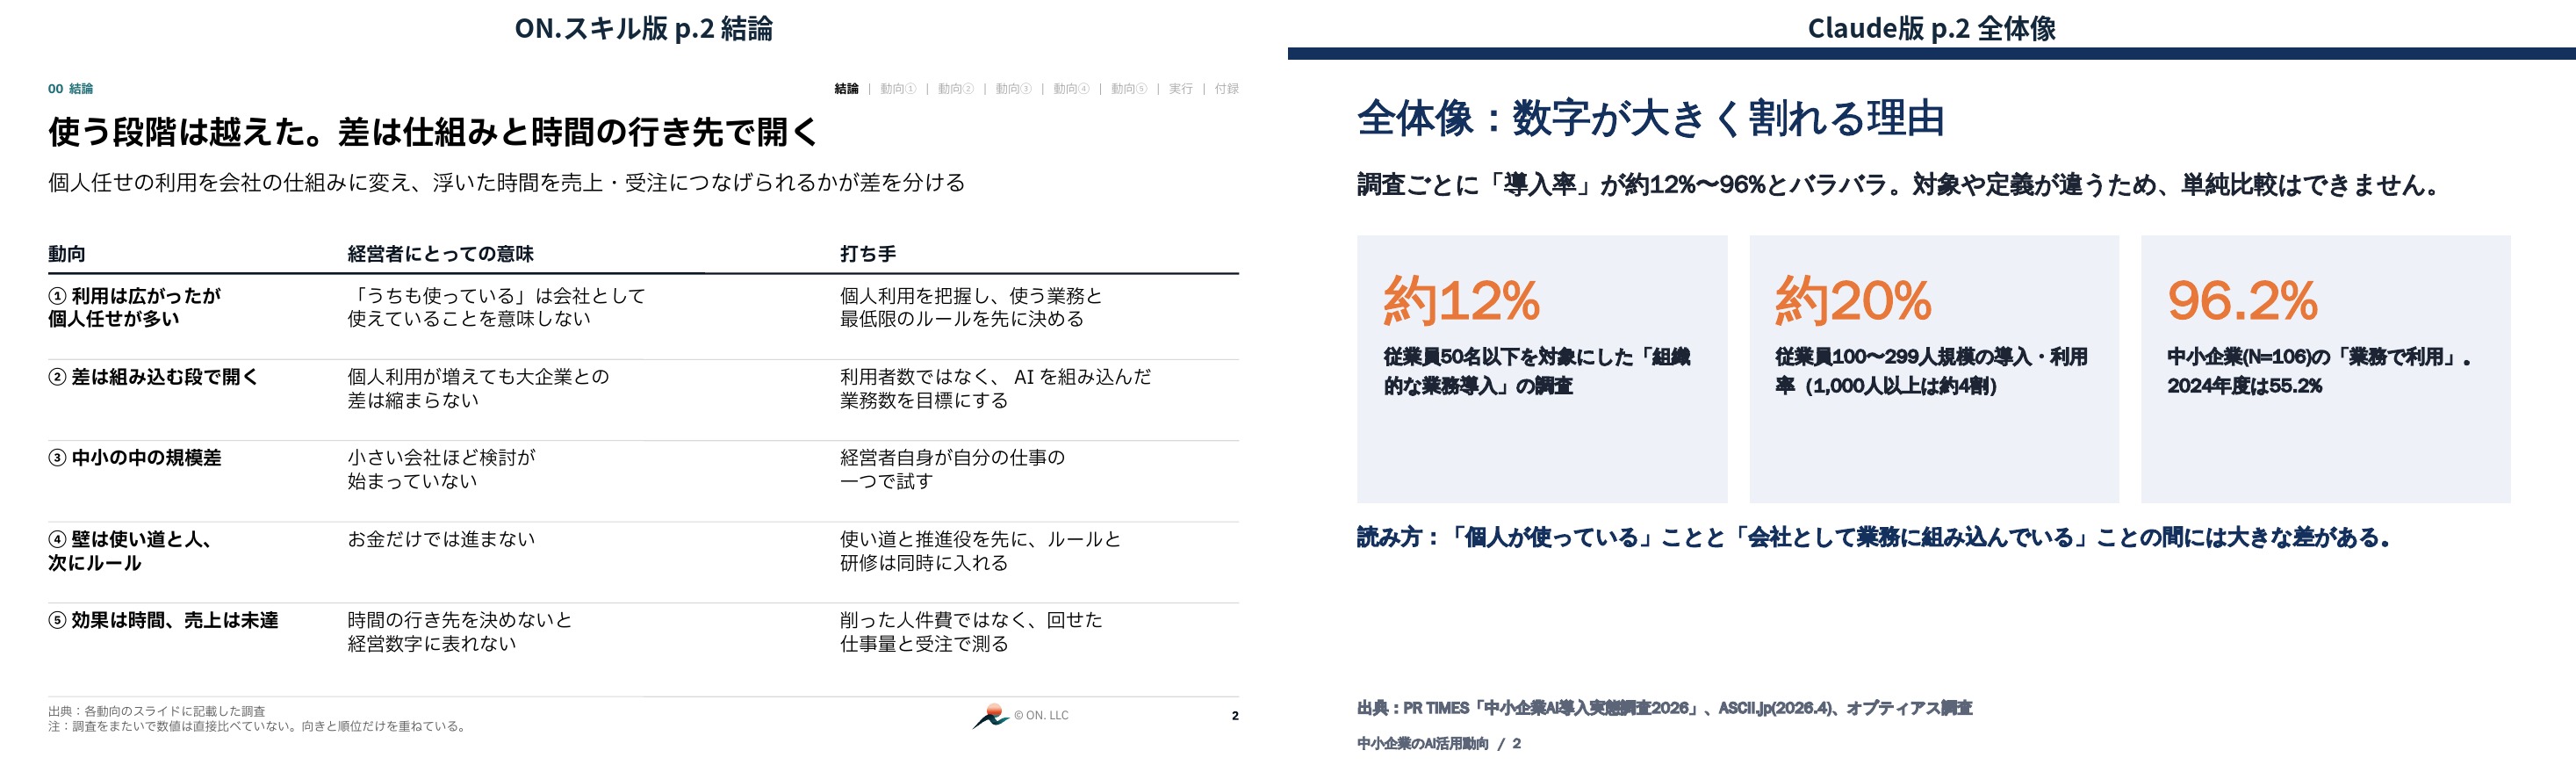
2枚目も対照的です。
ON.スキル版は「結論」ページです。タイトル自体が結論(「使う段階は越えた。差は仕組みと時間の行き先で開く」)で、5つの動向を「動向/経営者にとっての意味/打ち手」の3列に整理しました。この1枚で、資料全体の主張と、経営者が取るべき行動が読めます。
Claude版の2枚目は「全体像」です。「導入率は調査ごとに約12%〜96%とバラバラで、単純比較はできない」という指摘自体は正しく、誠実です。ただし、置かれているのは大きな数字3つだけで、結論は「読み方:個人利用と会社としての活用には差がある」という一文に留まります。数字を大きく見せることと、結論を示すことは、別の作業だということがよく分かる対比でした。
なお、Claude版に結論らしいページがないわけではありません。最終10枚目に「まとめ:次の一手」があります。ただ、そこにあるのは「困りごとを1つ選ぶ」「ルールを決める」といった一般的な4ステップで、本文の数字とは結びついていませんでした。
4. 差① データの集め方:一次ソースか、まとめ記事か
内容の差で最も大きかったのは、どの調査を、どう使ったかです。
ON.スキル版が使ったのは、すべて公的機関・調査機関の一次資料です。日本商工会議所のLOBO調査(2026年8月、有効1,920社)、信金中央金庫の特別調査(2026年9月、n=12,766)、東京商工リサーチの生成AIアンケート(2026年4月、有効6,327社)、中小企業白書2026(n=3,888)、IPA「DX動向2026」(n=853)などです。各ページの脚注に、調査名・公表時点・サンプル数を明記しました。
Claude版の出典は、質が異なります。PR TIMESで配信された事業者の調査、ニュースサイト(ASCII.jp)の記事、調査レポートの「引用」「ほか」という表記が中心です。数値も「約12%」「約20%」「約4割」といった概数が多く、サンプル数が書かれているのは、実質的にはツール利用率のページ(中小企業N=106)のみでした。N=106の調査を根拠に「複数ツールを使い分ける企業が主流に」と言い切るなど、根拠の強さに対して、言い切りが強い箇所も見られます。
ChatGPT版は、この点では健闘しています。中心の出典は中小企業基盤整備機構の実態調査(2026年3月公表、n=1,647)という一次資料で、調査期間まで脚注に入っています。ただし、ほぼ1つの調査への依存が大きく、導入企業のサンプル数がページによって322と327に揺れている点は、検算で見つかった弱点です。
経営資料で出典が弱いと、何が困るのでしょうか。会議で「その数字、どこから来たのか」と聞かれたときに答えられず、資料全体の信用が下がります。出典の確かさは、見た目の問題ではなく、意思決定に使えるかどうかの問題なのです。
5. 差② 数字の扱い:比べていい数字と、比べてはいけない数字
このテーマには、落とし穴があります。調査ごとに「中小企業」の定義も、「AI活用」の聞き方も違うため、異なる調査の数字を横に並べて比べると、間違った結論が出ます。
この点、3つとも「単純比較はできない」という注意は書いていました。違いは、その先です。
ON.スキル版は、数字を比べる場合は同一調査の中だけに限定し、調査をまたぐ場合は「向きと順位だけを重ねる」と、各ページの注記で宣言しました。そのうえで、掲載したすべての「差」と「合計」に、計算の過程を注記しています。たとえば――
・「会社として使う会社 34.9%」= 全社的 11.5% + 特定部門 23.4%(LOBO)
・「組織的活用の差 19.9pt → 26.8pt」= 各時点の大企業の値から中小の値を引いて計算(東京商工リサーチ)
・「使う会社の約7割は個人利用 73.4%」= 個人中心の合計 26.5% を、利活用 36.1% で割って計算(信金中央金庫)
読み手が、その場で検算できます。実際、当方で全ページの主要数値を表示値同士で引き直し、食い違いはありませんでした。
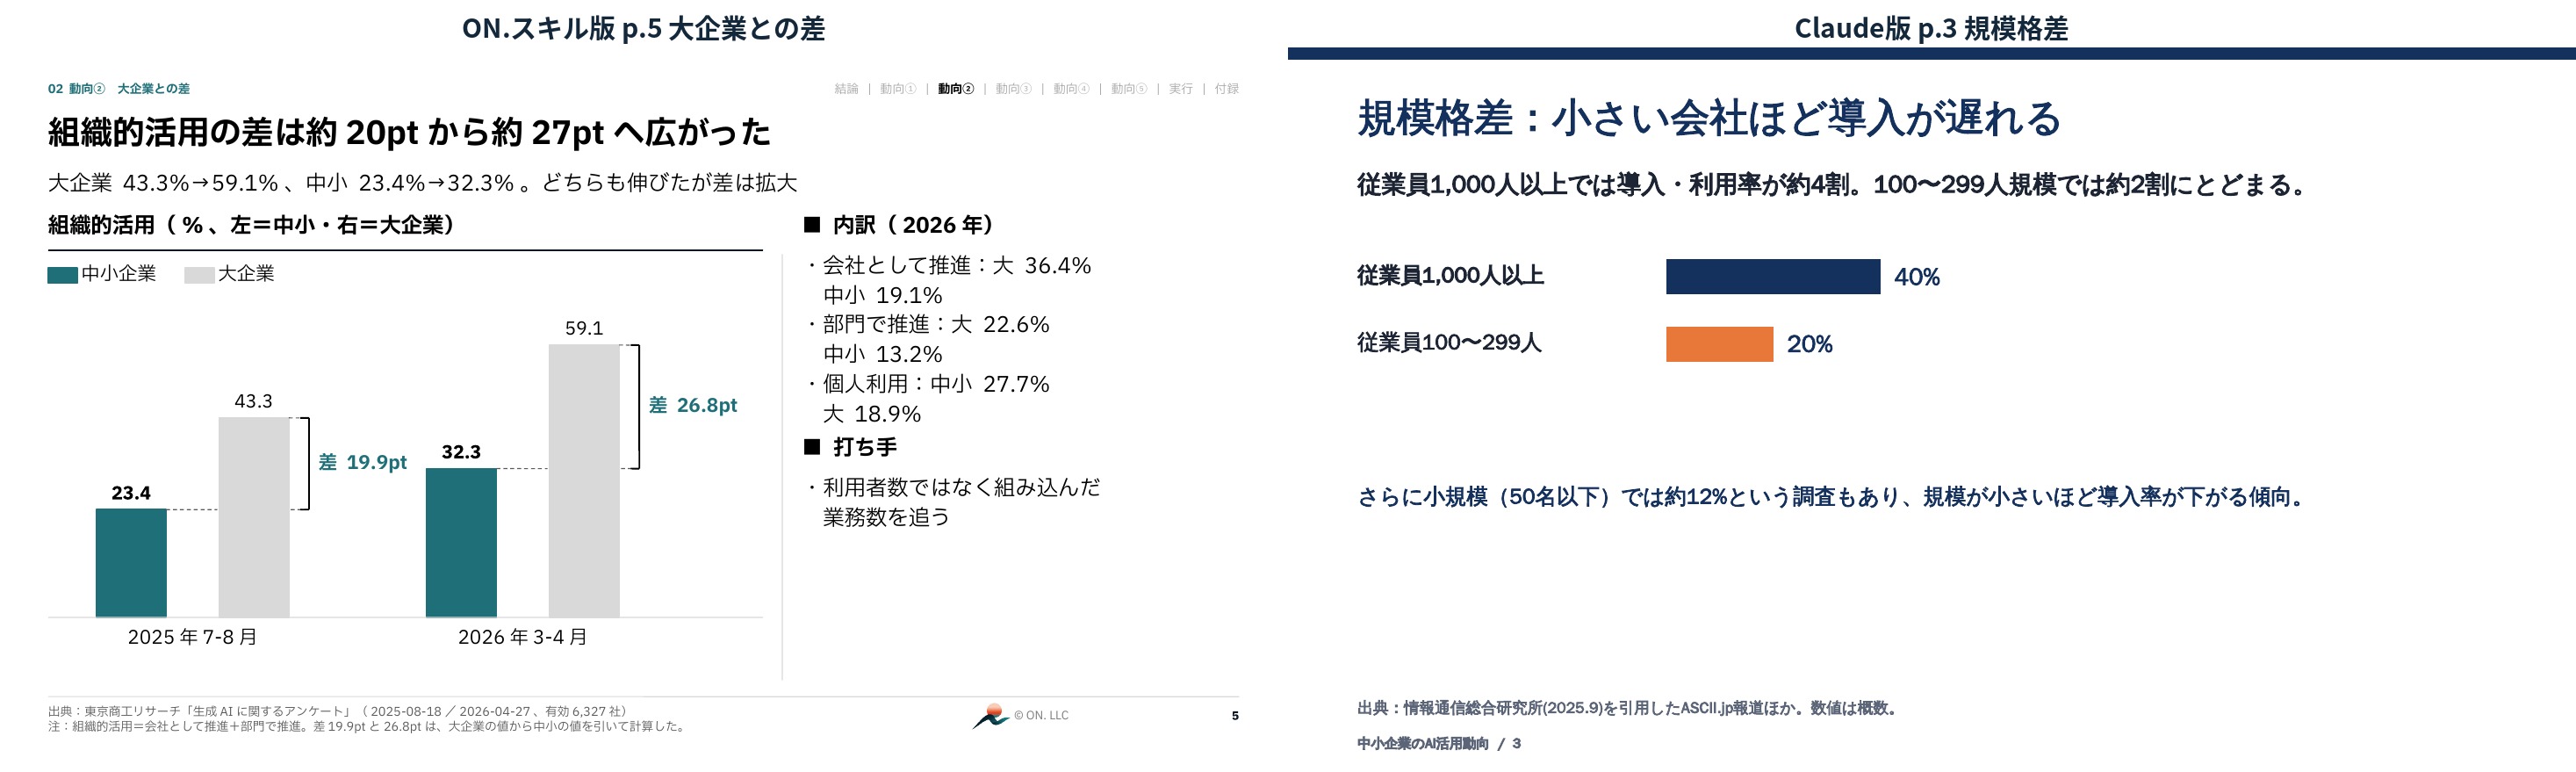
図表の作法にも、差が出ています。
左のON.スキル版は、左にグラフ、右に「内訳」と「打ち手」を置く形です。棒には必ず凡例(色の意味)を付け、2つの棒の「差」は、両方の天面から点線を引き、範囲を最後まで描き切ったブラケットで示し、値(差 19.9pt/差 26.8pt)をその横に置きました。「どれだけ違うか」が、数字と形の両方で読めます。
右のClaude版は、棒が2本だけです。40%と20%という値は分かりますが、出典は「報道ほか。数値は概数」で、差を示す作図も、右側の示唆もありません。ページの下半分は、ほぼ空白でした。さらに別のページ(業種差)では、タイトルで「建設業や運輸・郵便業などは低水準」と述べながら、図にあるのは情報通信(40%)と小売(20%)だけで、建設・運輸の数字がページ内に存在しません。タイトルと図が一致していない例です。
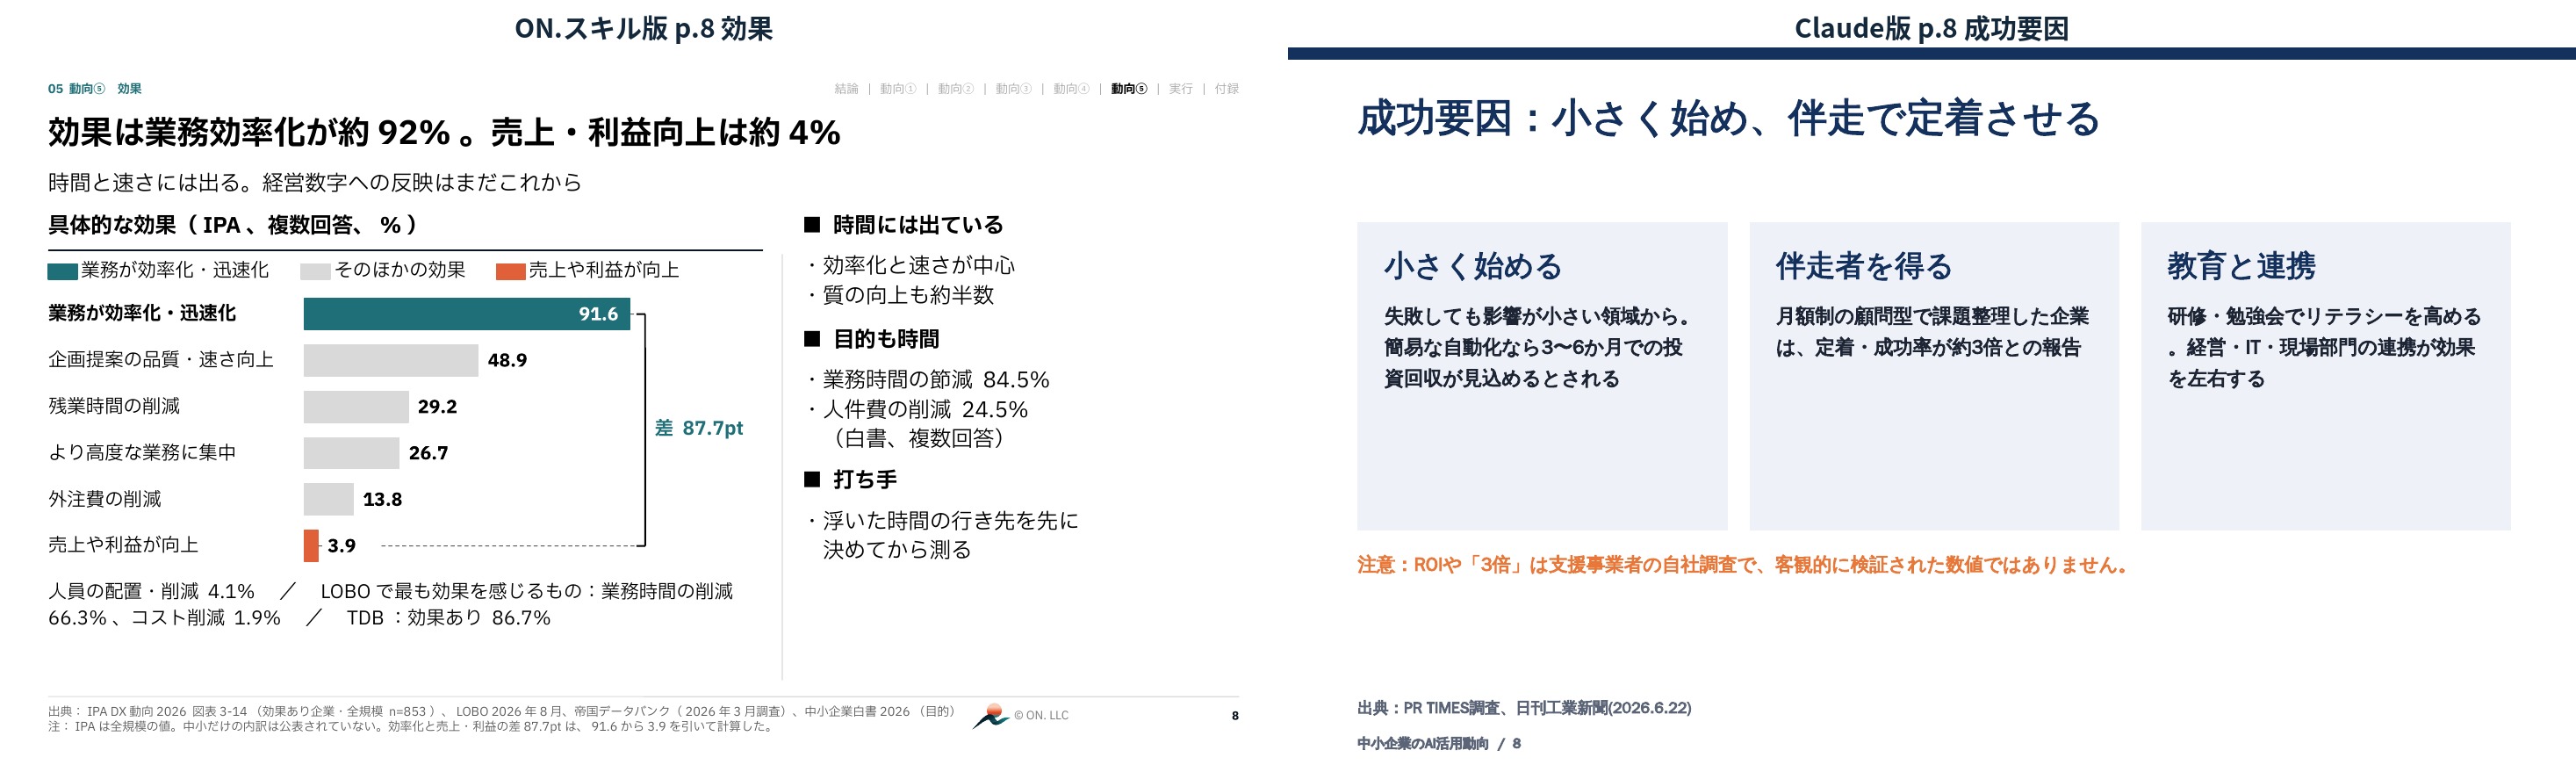
効果のページも対照的でした。ON.スキル版は「効果は業務効率化が約92%。売上・利益向上は約4%」と対比をタイトルにし、差 87.7ptをブラケットで示しました。経営者への含意(浮いた時間の行き先を先に決める)が、その場で読めます。
Claude版は「成功要因」を3つのカードで並べたページで、「伴走支援を受けた企業は定着・成功率が約3倍」という、支援事業者の自社調査の数字を載せています。下部に「客観的に検証された数値ではありません」と注意書きがある点は誠実です。ただ、注意が必要な数字を本文の中心に置く構成自体は、会議資料としては勧められません。
6. 差③ 資料としての体裁:表紙・余白・現在地
内容の次に効いてくるのが、資料としての体裁です。表紙があるか、ページの余白の使い方が整っているか、読み手が全体の中の現在地を見失わないか。地味ですが、会議で手に取られたときの印象は、ここで決まります。
ChatGPT版は、ページデザインそのものは統一されています。上部の帯、色分けされたカード、出典の脚注という組み立てが全ページでそろい、図6の2枚を見比べても、同じ資料だと一目で分かります。弱点は、やはり表紙がないことです。1枚目の要旨が表紙を兼ねる作りで、タイトル・発行元・日付をまとめて示すページがありません。社外に渡す資料としては、最初の1枚で「誰の、何の資料か」が言い切れていません。
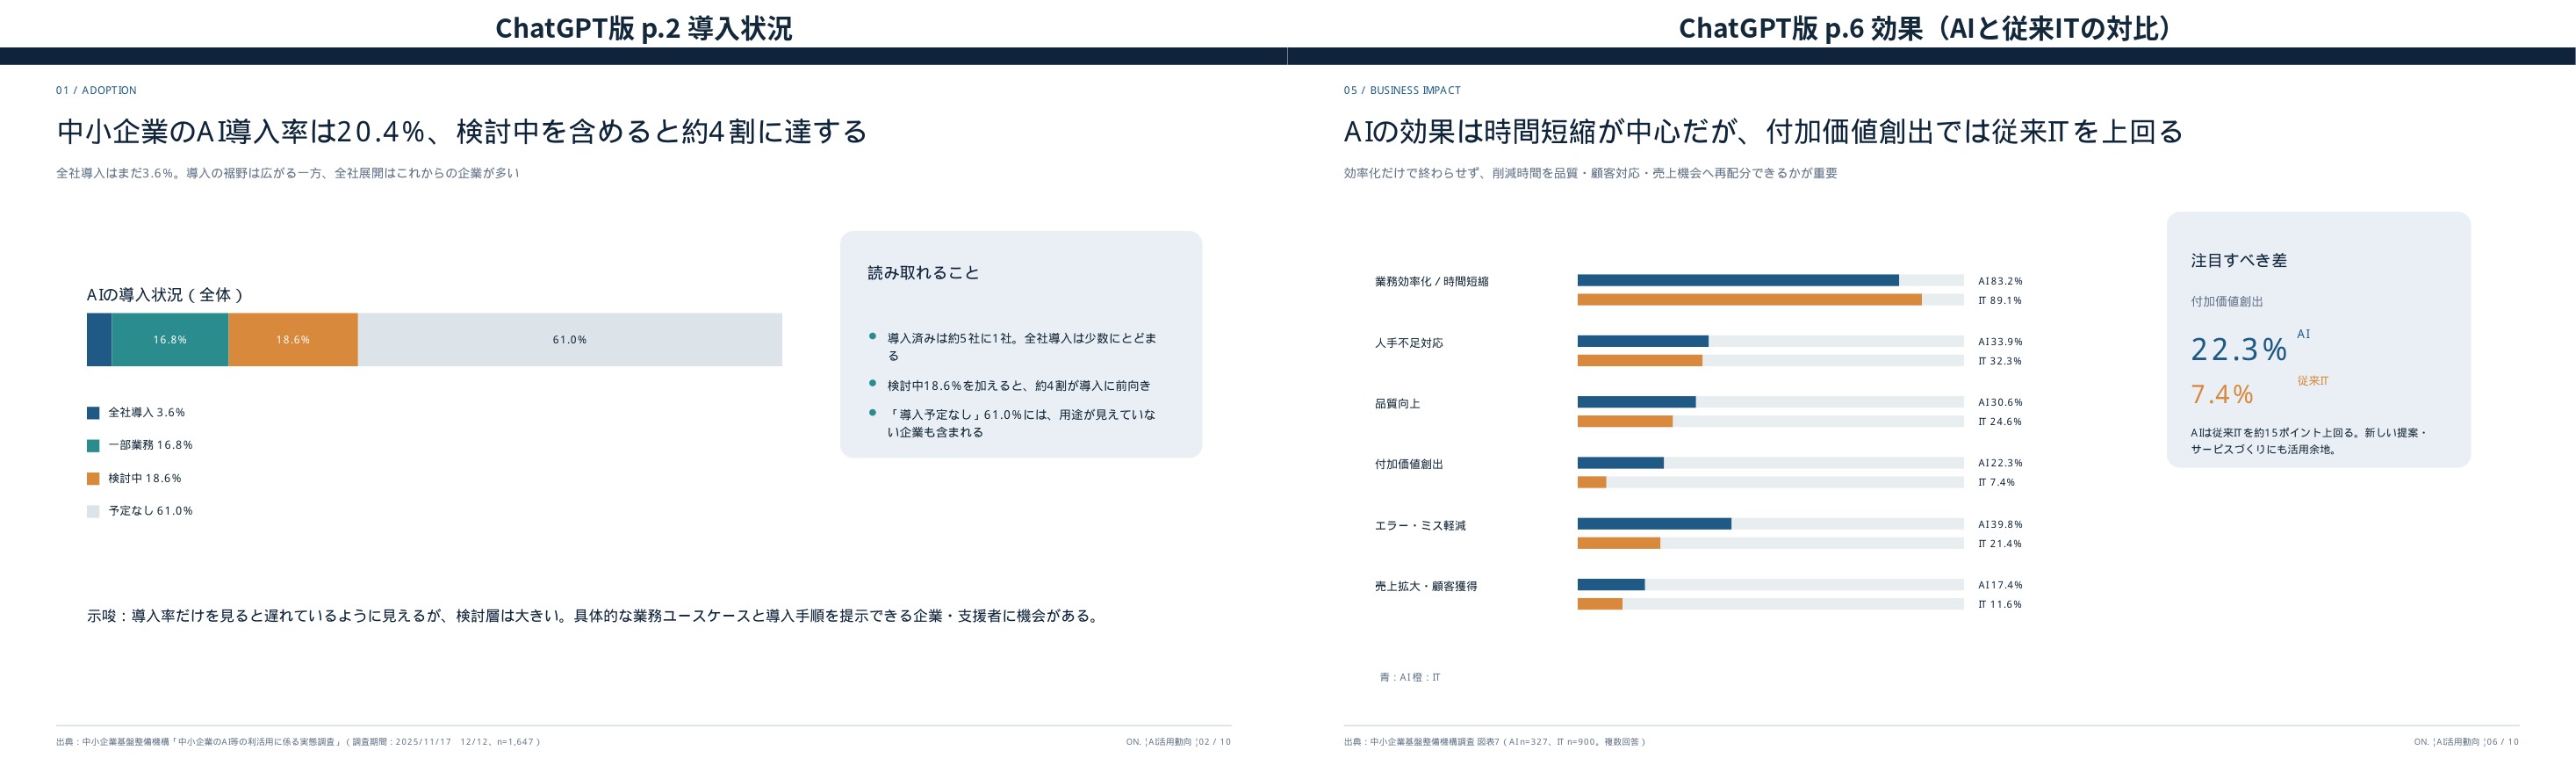
Claude版は表紙こそありますが、情報量が少なく、ページの下半分が空白のページが目立ちました。全10ページの文字数は約2,220字で、ON.スキル版(約4,340字)のほぼ半分です。余白そのものは悪ではありませんが、「10枚でまとめて」という依頼に対しては、各ページに置くべき内容がまだ置かれていない、という印象になります。
ON.スキル版は、表紙にタイトルと宛名、発行元を置き、全ページにページ番号と現在地を示すトラッカー(結論/動向①〜⑤/実行/付録)を入れています。どのページを開いても、資料全体の中での位置が分かります。出典の詳細は付録に分離し、本文のページは主張とデータに集中させる作りです。
表紙で受け取り、現在地を見失わず、最後まで同じ作法で読めること。 その当たり前を10ページ通して守れるかどうかが、体裁の完成度の差でした。
7. 差④ 打ち手の具体性:読んだ翌日に、何をするか
最後の差は、読み手の行動につながるかどうかです。
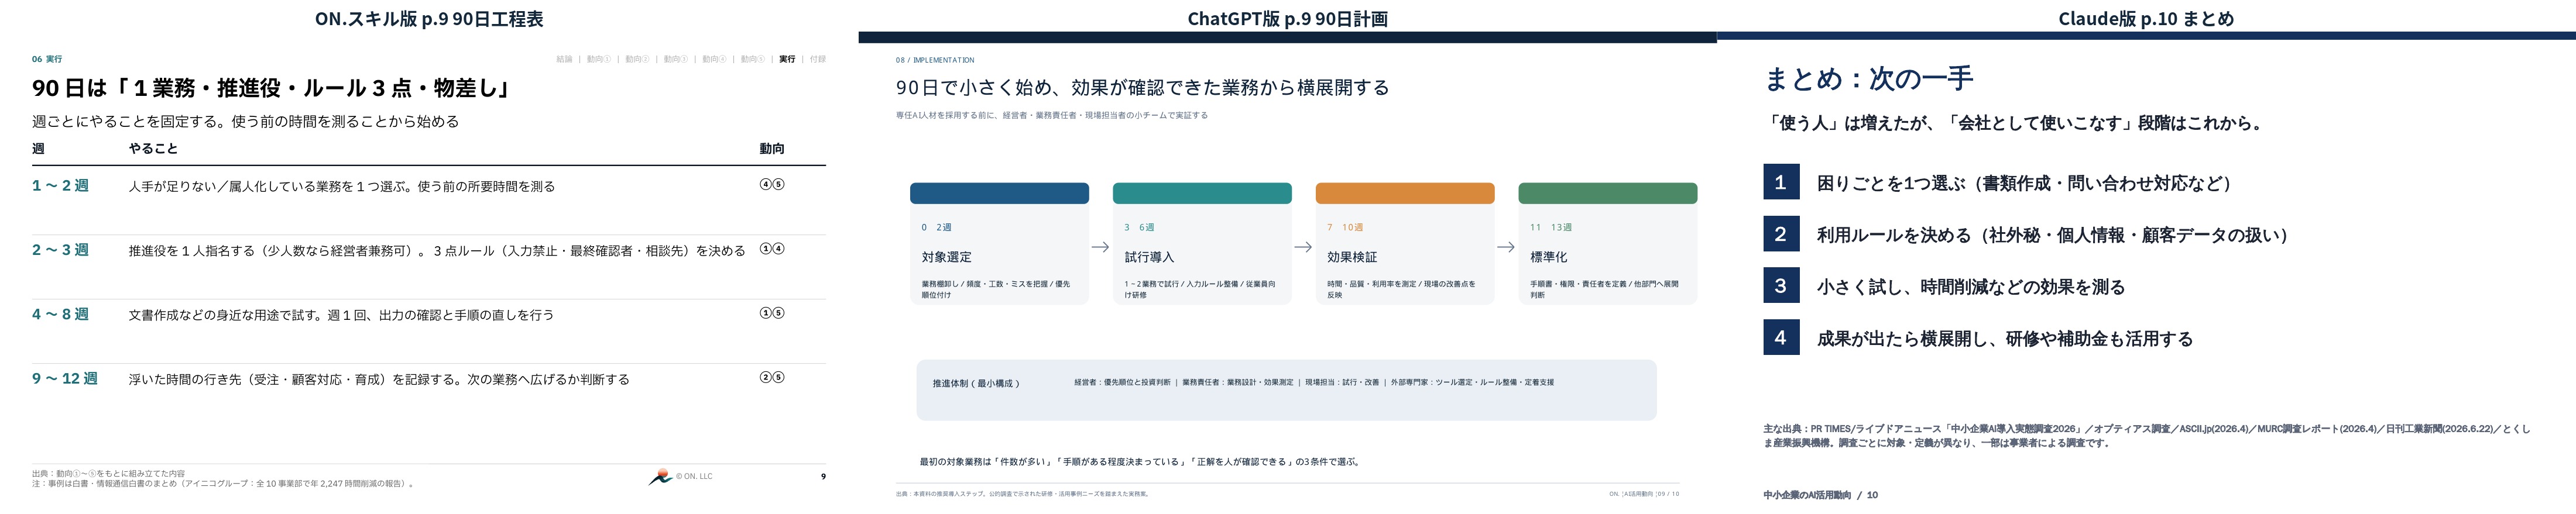
ON.スキル版は、実行ページを2枚用意しました。1枚目(図5左)は「90日は『1業務・推進役・ルール3点・物差し』」として、週ごとにやることを固定した工程表です。各行には、その打ち手がどの動向(データ)に基づくかを示す番号も付けました。2枚目は物差し(KPI)で、「測るのは利用者数ではなく、組み込んだ業務数と回せた仕事量」とし、KPIを4点に絞ったうえで、「やめる・始める」を対で並べています。なお、規模差が大きいテーマなので、一律の数値目標は置かない、と明記しました。
ChatGPT版の打ち手も、具体的でした。90日を「対象選定→試行導入→効果検証→標準化」の4段階に分け、推進体制(経営者/業務責任者/現場担当/外部専門家)まで書いた計画(図5中)に加え、別のページでは投資効果の計算式(年間効果額 = 削減工数 × 処理件数 × 人件費単価 + 追加効果 − 運用費)と、ガバナンスの最低限の設計(入力情報/出力確認/権利・安全/アカウント)まで踏み込んでいます。内容面では、ON.スキル版に次ぐ水準です。
Claude版の締めは、前述の4ステップです(図5右)。「小さく試す」「ルールを決める」という方向は正しいものの、期間、担当、測る数字までは踏み込んでいません。読み手が翌日に何をするかは、読み手に委ねられています。
経営資料の役割は、情報を並べることではなく、判断と行動を前に進めることです。打ち手の具体性は、そのまま資料の価値になります。
8. それでも、素のAIは健闘していた
公平のために、スキルなしの2つができていた点も、書いておきます。
・タイトルは、3つとも「主張の文」になっていました。「現状と課題:」のような分類名をタイトルの前に付ける、いわゆる“AIっぽい”型は、今回は見られませんでした
・Claude版は、「調査ごとに導入率が割れる理由」を冒頭で正面から取り上げ、安易な単純比較を戒めていました。「成功率3倍」への注意書きも含め、数字への留保を書く姿勢はありました
・ChatGPT版は、構成(要旨→導入実態→用途→効果→壁とガバナンス→投資評価→90日計画→経営への含意)は論理的で、ガバナンスや投資評価まで踏み込んだ、内容面では最も“コンサル資料らしい”作りでした。弱点は表紙がないことなど、資料の体裁の詰めにあります
・棒グラフそのものは、3つとも値と長さがおおむね比例していました。見た目が大きく崩れることは、もはや起きにくくなっています
つまり、素のAIの水準は上がっています。それでも差が残ったのは、「最後まで検算する」「出典を一次資料で固める」「相手の環境で読める形で納める」という、地味な工程の部分でした。
9. 差を生んだのは「スキル」:作成前に決めてあること
では、ON.スキル版は何が違ったのか。モデルへの指示文(プロンプト)は同じ一文です。違いは、AIが作業を始める前に読み込む「スキル」――戦略コンサルタントスキルと、スライド作成スキルの中身です。主な要素を紹介します。
9-1. 調査の規律(戦略コンサルタントスキル)
・意思決定から入る:何を、誰のために決めるのか(キー質問)を1つに絞り、仮説を立ててから調べる
・数字には、出典名・発行元・時点・URL(または公表情報)を必須とし、一次ソースを優先する。出典や母数の違う調査の数字を、直接比べない
・推計や計算は、過程を分解して示し、別の角度からも確かめる
・固まった分析は、キーメッセージ、ストーリーライン、スライドごとの裏付けと出典、未確認事項を記した「ハンドオフ」にしてから、資料作成に渡す
今回のテーマでは、この規律が「調査をまたいで比べない」「差は同一調査の中で計算し、過程を注記する」という形で、そのままスライドに表れています。
9-2. 版面の規約(スライド作成スキル)
過去のレビューで受けた指摘を、チェックリストとして蓄積し、案件のたびに作成前に読み直します。代表的なものです。
・タイトルは主張の文にする。タイトルだけを通して読んでも、話がつながる構成にする
・グラフのページは「左に図、右に示唆・打ち手」。図の下に結論を言い直す帯は置かない
・棒グラフには、色の意味を示す凡例を必ず付ける。数字だけを大きく見せる見せ方はしない(数字は、それが属する主張や図表の中に置く)
・「差」は、短い点線と浮いた数字で済ませず、ブラケットや両矢印で範囲を最後まで描き切り、値をその横に置く
・文字は本文16pt、図表内でも14ptを下限とする。小さくして詰め込まない。左右に対置する構成は、比率を全ページでそろえる
・各ページに、出典と、計算した場合の注記を置く。自己言及や抽象的なラベル(「根拠」「本稿」など)は使わない
・装飾のための色帯や、意味のない線は置かない。配置には意図を持たせる
9-3. 型(パターン)と実物の確認
レイアウトは、その場の思いつきでは決めません。パターンカタログ(定義126種)から、そのページで伝える関係に合う型を選び、土台にする実物のスライド(承認済みの完成資料)を描画して寸法を実測してから組みます。「型の空欄を埋める」のではなく、「このページで伝えることを決め、合う型を使う」順番です。
9-4. 検証の工程
完成扱いにする前に、次を行います。
・機械チェック:はみ出し、仮の文字の残置、出典の欠落、文字サイズなどを検出し、FAIL 0を確認する
・全ページの目視:原寸で全ページを見て、改行の位置、重なり、図とタイトルの一致を確かめる。機械チェックは補助で、最後は目で決める
・数字の再検算:主要な数値を、表示値同士で引き直す。差や合計が再現できないものは直す
・構成と見本の確認(ゲート):いきなり全編を作らず、構成表と見本数枚の段階で、人の確認を挟む
手間はかかります。ただし、この工程があるから、「1発目の依頼」で、検算の通った資料が出てきます。スキルとは、言い換えれば「前にもらった指摘を、次の資料でも必ず効かせる仕組み」です。
10. この検証の限界
正確のために、限界も明記します。
・お題は1つ、各AIとも試行は1回です。同じ依頼でも、出力は毎回変わります。今回の点差が、そのまま各サービスの実力差を表すものではありません
・採点はON.編集側が行いました。観点と配点は本文のとおり公開しますが、第三者による盲検ではありません
・Claude版・ChatGPT版のモデル名や細かな設定は、ファイルに記録がなく、本コラムではサービス名のみで表記しています
・ON.スキル版には、スキルの工程として構成・見本の確認(人の承認)が含まれます。「依頼が一文だけ」という条件はそろえましたが、「AIが完全に無人で出したもの」ではありません。その工程込みが、スキルの設計です
11. 資料作成のご相談のご案内
ON.は、経営企画BPO(月次での伴走支援)と、プロジェクト型の企業変革支援を行う、合同会社です。資料作成は、その中でも「経営会議で判断に使う資料」を対象に、調査の裏付けから、構成、版面、検算までを一貫して担います。
・「AIに作らせた資料が、会議で使える水準にならない」
・「数字の出典や計算を問われると、答えに詰まる」
・「資料の型が担当者ごとにばらばらで、レビューの指摘が毎回同じになる」
こうした状態であれば、本コラムで紹介した「規約と工程を先に決める」進め方が、そのまま効きます。自社内でAIにスライドを作らせる場合も、最初にやるべきはプロンプトの工夫ではなく、レビューで繰り返す指摘を、具体的なルールとして書き残すことです。
資料作成や経営企画の進め方に関するご相談は、ON.のサイトからお寄せください。
ご相談:https://on-inc.co.jp/#contact
まとめ
同じ一文を3つのAIに渡して分かったのは、差は「描く力」ではなく、「確かめる工程」にあった、ということです。
・出典は一次資料で固め、調査名・時点・サンプル数を各ページに残す
・数字は、比べてよい範囲の中だけで比べ、差と合計は検算できる形で置く
・図表は、凡例と「差の描き切り」で、数字と形の両方から読めるようにする
・打ち手は、期間・担当・物差しまで落とす
・そして、相手の画面で読める形で納める
AIの水準は、今後も上がっていくはずです。それでも、「何を良い資料とするか」を自社の言葉で決め、指摘をルールとして残し、次の作成で必ず読ませる――この蓄積は、モデルが変わっても残ります。
まずは、手元の資料を1枚選んで、「このページで伝えることは何か」「数字は検算できるか」「出典は答えられるか」を点検してみてください。そこから、御社の資料の規約づくりが始まります。
お問い合わせ
合同会社ON. https://on-inc.co.jp
〒220-0004 神奈川県横浜市西区北幸二丁目10番48号 むつみビル3階
事業内容:企業変革支援/海外展開支援/自社ブランド
(検証データ)比較に使った3ファイル:ON.スキル版「中小企業のAI活用動向」PDF(10枚)、Claude版PDF(10枚)、ChatGPT版PDF(10枚)。いずれも2026年11月5日に、同一プロンプトで作成されたもの。